一款基于 C++17 与 wxWidgets 打造的现代化、高颜值跨平台桌面离线 AI 翻译、StarDict 离线词典与多模态 OCR 视觉助手。深度整合 llama.cpp 原生推理引擎与内嵌后台服务,推荐搭载腾讯 Hy-MT2-1.8B-GGUF 高性能离线翻译模型与 PaddleOCR-VL 视觉大模型。现已原生支持 Windows 10/11 与 macOS (Apple Silicon / M系列芯片),支持全局快捷划词翻译,100% 离线计算,严密守护您的隐私安全。
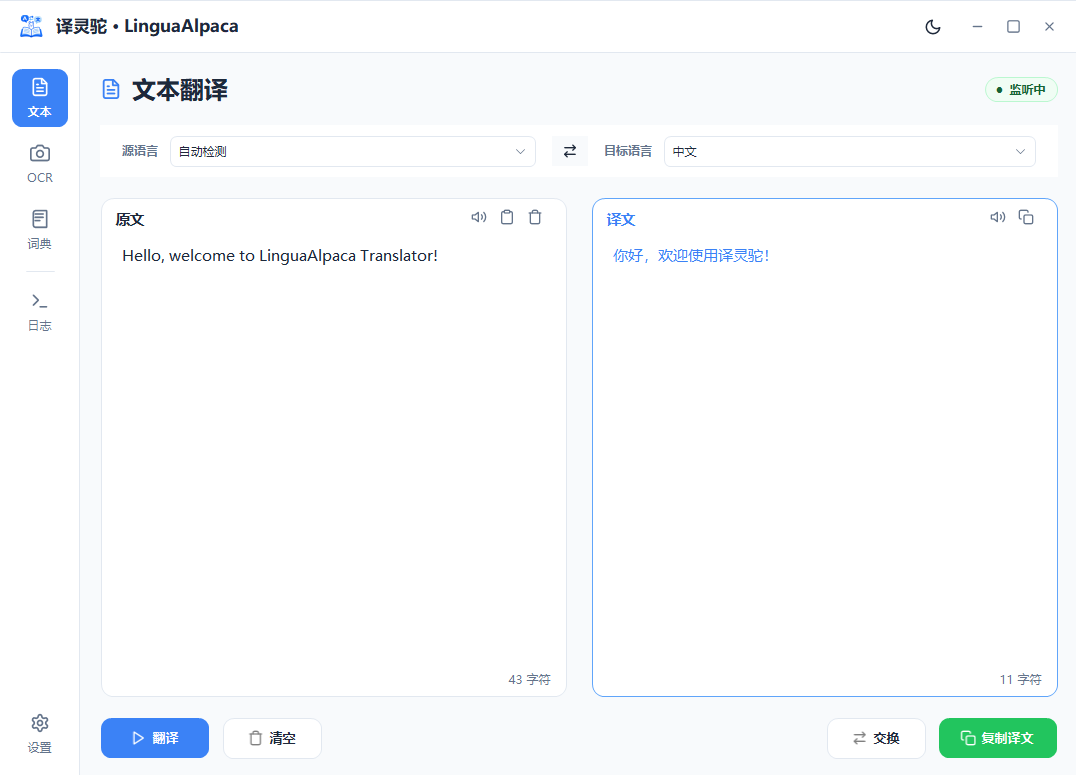
深度打磨每一个像素与交互细节,从端侧大模型长文本翻译到毫秒级全局划词与多模态视觉图文识别,无缝融入日常工作流。
内嵌 llama.cpp 原生引擎,搭载腾讯混元 Hy-MT2 翻译模型。支持多语种流式互译,上下文理解深刻,行文自然地道,100% 本地离线计算。
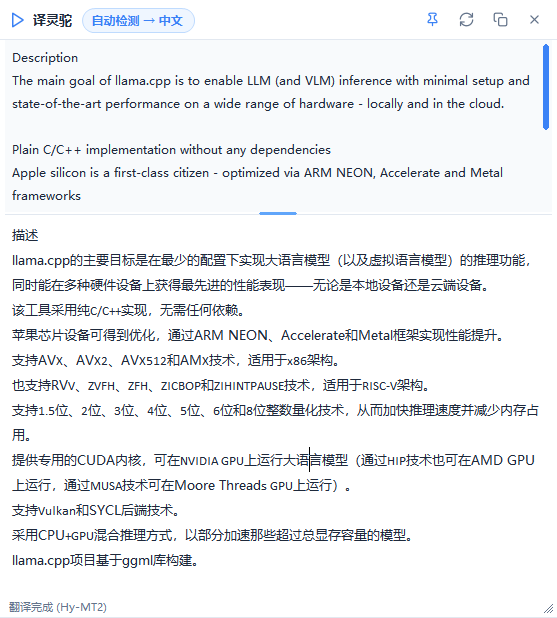
在任意软件、PDF 或网页中选中文字即可一键呼出悬浮窗。支持光标跟随、Pin 钉住置顶与一键复制,让查阅无缝融入生产力工作流。
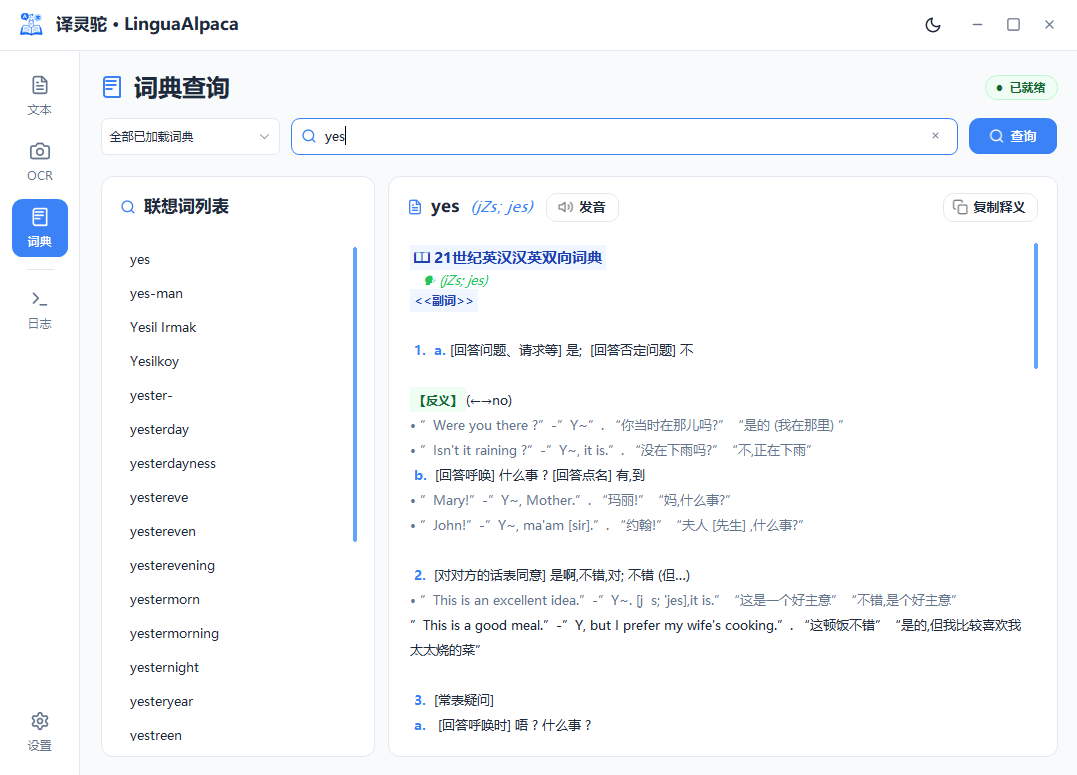
原生兼容 StarDict 标准词库,内置权威本地词典。基于本地倒排索引实现毫秒级查词,音标、词形变化与权威例句一网打尽,断网可用。
集成 PaddleOCR-VL 视觉多模态大模型。支持全局快捷截图、图片文字高精度提取与智能版面重构,不可复制的文档与图片一键轻松翻译。
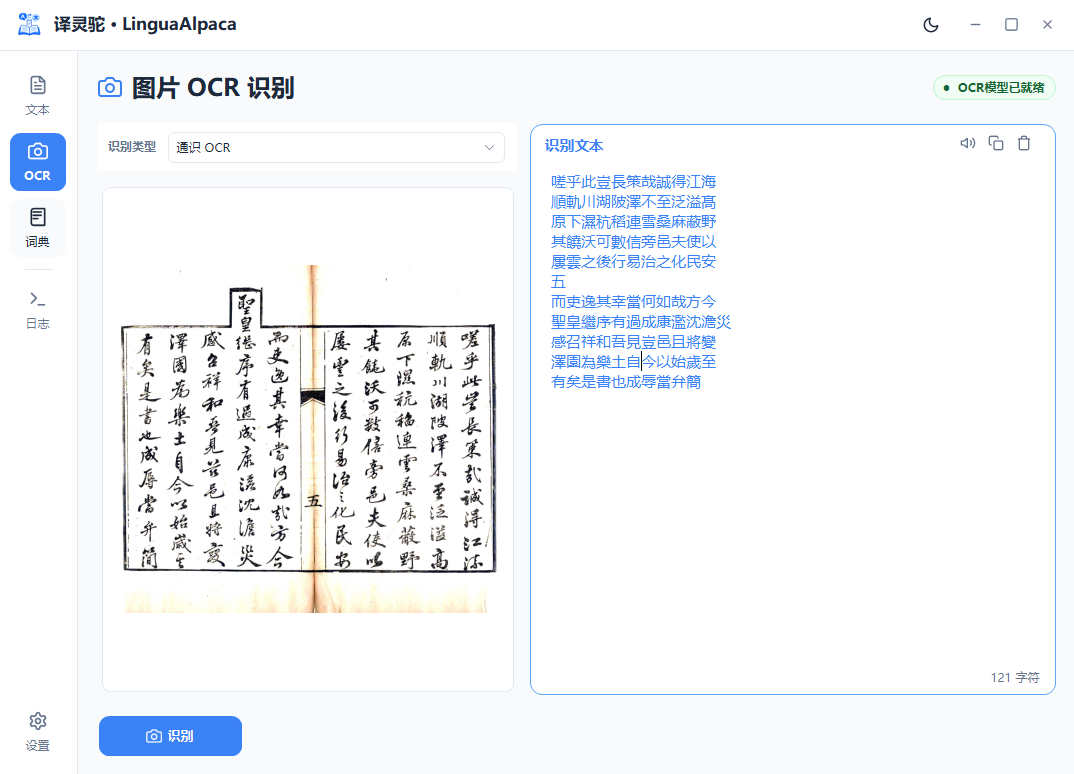
摆脱云端 API 计费困扰与网络延迟,拒绝 Electron 资源黑洞,将顶尖 AI 翻译算力完整封装着于您的本地电脑。
所有大模型推理、词典检索与 OCR 识别全链路运行在本地内存与算力中。零外部请求,零数据上传,企业核心机密文档、商业合同与个人隐私万无一失。
拒绝 Electron 动辄数百兆的浏览器内核开销。采用现代 C++17 纯原生编写,配合 wxWidgets 高性能 GUI,启动快如闪电,内存占用小,轻盈丝滑。
内嵌 llama.cpp 核心 C/C++ 推理后端,完美利用现代 CPU 向量指令集 (AVX2 / AVX-512) 与 GPU 硬件加速 (Vulkan / CUDA / DirectML),充分压榨硬件潜能。
官方重点推荐搭载腾讯 Hy-MT2-1.8B-GGUF 高性能翻译模型。参数量精悍小巧,译文质量媲美百亿参数在线模型,长难句解析、术语转化与语调极具地道感。
将业界强劲的 PaddleOCR 视觉多模态大模型整合进桌面工作流。支持全局截图取词、图片文本提取、复杂排版格式保留与一键图文对照翻译。
无缝融入您的代码阅读、文献研读与多任务办公。任何程序中划词即刻唤醒悬浮窗,搭配 StarDict 本地海量词库与 AI 深度分析,助您无障碍阅读世界知识。
以极简优雅的 C++17 原生代码为纽带,将本地推理引擎、视觉多模态大模型与词典检索模块紧密耦合。
译灵驼采用分层模块化设计:GUI 层基于高效稳定的 wxWidgets 构建,推理层无缝直连 llama.cpp 原生 C/C++ 共享库与后台嵌入式守护进程,离线词典层采用倒排索引极速检索。
运用现代 C++ RAII、智能指针与多线程并发模型,全面原生支持 Windows 10/11 与 macOS (Apple Silicon / M系列芯片)。
支持 Q4_K_M、Q5_K_M、Q8_0 等主流 GGUF 量化格式,动态自适应线程调度,保持系统平稳不卡顿。
毫秒级本地二进制字典读取,无缝集成 PaddleOCR-VL 视觉算法,打造集翻译、查词、识图于一体的超级全能助手。
对比云端在线翻译 API、传统查词软件以及基于 Electron 的 AI 翻译工具,体验全方位的代差优势。
| 对比维度 | 译灵驼 · LinguaAlpaca | 在线翻译 API / 网页 | 传统查词软件 (有道/金山) | Electron 架构 AI 客户端 |
|---|---|---|---|---|
| 100% 离线隐私安全 | 完全离线,零数据上传 | 全部数据上传云端服务器 | 依赖网络查询与推送 | 多数依赖 OpenAI/云端 API |
| 核心构建框架 | C++17 + wxWidgets | 浏览器网页 / 云端集群 | 传统桌面混合框架 | Chromium + Node.js (臃肿) |
| 系统内存占用 | < 80MB (模型按需加载) | 浏览器标签页 300MB+ | 200MB - 500MB+ (含广告进程) | 600MB - 1.5GB+ (极占内存) |
| 翻译地道度与上下文 | 混元大模型深层上下文理解 | 质量较好(受网络影响) | 传统机翻生硬直译 | 依赖云端大模型 |
| 百万离线词典 | 原生支持 StarDict 本地词库 | 无离线词典能力 | 支持本地词典包 | 多数无专门词典索引 |
| 视觉多模态 OCR | PaddleOCR-VL 本地截图识译 | 需上传图片,计费昂贵 | 基础 OCR,次数受限 | 需配置云端 Vision Key |
| 使用费用与成本 | 100% 永久免费开源 | 按字符计费 / Token 订阅制 | 大量弹窗广告 / 会员收费 | 需购买商业 API Token |
告别繁琐的环境配置,开箱即用的 Windows & Mac 双平台便携客户端,轻松畅享本地 AI 生产力。
前往 GitHub Releases 下载最新发布的 Windows 10/11 64位压缩包或 macOS (Apple Silicon / M芯片) 分发包,解压至任意工作目录即可开箱使用。
下载官方推荐的 Hy-MT2-1.8B-GGUF 翻译模型与 PaddleOCR-VL 模型,置于软件的
models/ 目录中即可自动识别。
启动软件,设置您习惯的全局热键(如 Alt + Q),在任意文档中选词即可唤醒悬浮窗,尽情探索无界知识!
关于离线模型配置、硬件要求与使用细节的常见疑问解答。
OCR 视觉多模态识别推荐使用 Hugging Face 上的 Mungert/PaddleOCR-VL-1.6-GGUF 离线量化模型。
针对不同的硬件配置,量化文件的选择可参考指南:Hugging Face GGUF Selection Guide | Layer Bumping with llama.cpp 进行选型:
Q4_K_M 等 4-bit
量化版本,显存与内存开销小,运行轻快流畅;Q6_K 或 Q8_0
等高位宽版本,更接近全精度基线,图文提取与复杂字符还原更精准;bf16_q8_0 等混合精度(Hybrid)或
BF16 / F16 全精度文件,关键层精度更高;
IQ3 等超低位宽版本,但会有一定程度的识别精度折损。PaddleOCR-VL-1.6-GGUF-mmproj.gguf 视觉多模态投影适配文件(Multimodal Projector),可能因
Vulkan 着色器算子的张量精度截断产生数值计算误差,导致解码器陷入异常退化循环,持续输出方块乱码字符(■)直至耗尽最大上下文窗口限制(Max
Context Limit)。mmproj 投影文件,以彻底规避计算误差,确保端到端视觉识别的稳定输出。
您可以访问知名的 StarDict 离线词库镜像站:StarDict Dictionaries (stardict.uber.space),免费检索并下载覆盖中英双解、多语种权威字典及专业学科术语的丰富词典包(如牛津、朗文、柯林斯、现代汉语词典、计算机词汇等)。
下载并解压后,只需将 StarDict 格式的词典文件(包含 .dict.dz、.idx 与 .ifo
三个文件)拷贝到软件根目录下的 dict/ 文件夹,随后在软件界面的词典管理菜单中点击“刷新”,系统即会自动建立倒排索引,享受即时百万词条的毫秒级离线检索。